2026 年 8 月 13 日晚,DeepSeek 以 MIT 协议开源了 DeepSeek Harness(简称 DSH),并把它明确定位为开发者预览版。据第三方监测,这个项目在开源约 42 小时后突破 10 万 GitHub Star,之后几天仍持续增长,速度在同类项目中相当罕见。很多人的第一反应是:“又一个对标 Claude Code 的编码工具。”
更值得追问的是:如果它只是复刻一个编码 Agent,为什么要把“智能体怎么循环工作”这种最核心的控制流也拆成可替换的插件?热度只是一周新闻,架构选择才是长期信号。这篇文章要做的,是把口号、机制、争议和野心分开看:它现在能做到什么,做不到什么,以及它真正想赌的东西是什么。
一、先把它从“又一个编码工具”的误会里拿出来
要理解 DSH,得先回到官方给出的公式:Agent = Model + Harness。模型负责“想”,它输出的始终只是一段文本;Harness 负责“做”,把这段想法接入文件系统、终端、网页、工具链和外部服务。没有 Harness,再强的模型也只是对话框里的一个聪明大脑。
这个公式并不是 DeepSeek 新造的。它最早由 LangChain 在《The Anatomy of an Agent Harness》里系统化提出,后来被 Anthropic 的 Claude Code 带进大众视野。Claude Code、Codex 这类产品,本质上是把某个模型和一套 Harness 绑定在一起的成品:上下文管理、工具定义、状态恢复、失败重试都由厂商预先搭好,普通用户只能在 Skill、MCP 这样的外围接口上做增量。
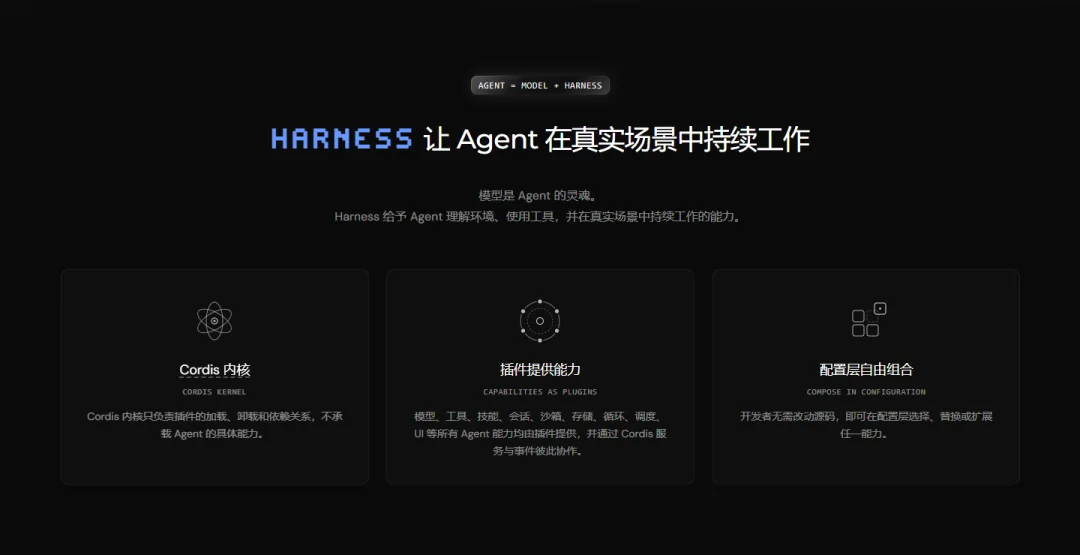
DSH 换了一种做法。它不交付一个“绑好的成品”,而是把模型适配器、工具注册表、会话日志、沙箱、调度逻辑、Agent Loop,甚至 Web UI 本身,全部做成地位平等的插件。官方第一句话“Everything is a Plugin”的狠处就在这里:连“读指令→调模型→执行工具→返回结果”这个核心控制流都可以整个换掉。
5 月时,DeepSeek 的 Harness 团队公开招聘桌面端 Agent 相关岗位的消息已经公开;三个月后它交出的答案不是“我们也做一个 Claude Code”,而是“我们把 Harness 这一层彻底拆开给你看”。把这两件事连起来,才能看清它的战略逻辑。
二、Cordis:为什么连“核心”都要拆成插件
过去的 Harness 像一栋浇筑好的大楼,核心和外挂边界分明。DSH 把这栋楼拆成一盒乐高,但随之而来的是一个更难的问题:所有零件都能动,怎么保证系统不散架?
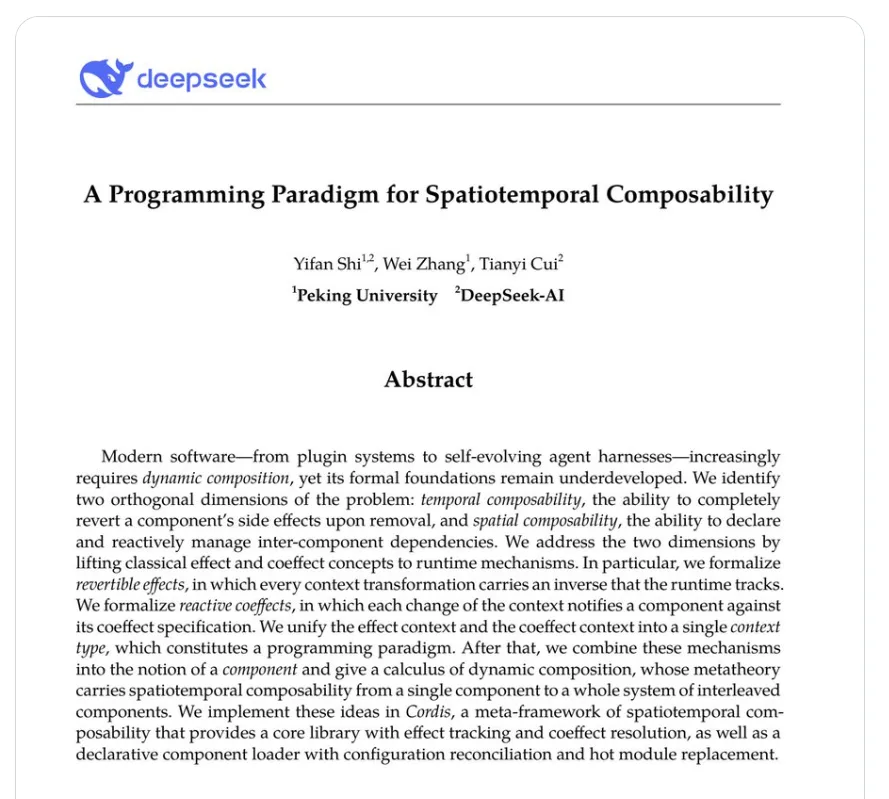
答案是一个叫 Cordis 的插件内核。它做的事极其克制,只负责插件的加载、卸载和依赖管理。与 DSH 同步发布的论文《A Programming Paradigm for Spatiotemporal Composability》(2026 年 8 月 13 日草稿,仍在持续修订)把它的目标概括成两个正交维度。
第一个是时间可组合性:一个插件卸载后,它此前对系统造成的影响能不能完整撤销。传统插件装上后会留下事件监听、定时器、内存和服务,卸载时清不干净,反复几次程序就越跑越乱。Cordis 要求所有对运行环境的修改都通过 ctx.effect 进行,每次修改同时登记对应的“逆操作”:注册监听时留下注销方法,启动定时器时留下关闭方法。运行时按相反顺序执行这些逆操作,把状态尽量恢复到插件加入之前。这套机制在论文里叫 revertible effects(可撤销副作用)。
第二个是空间可组合性:插件之间只声明“我需要什么”,不指名道姓绑定具体实现。一个聊天记录插件可以声明自己依赖数据库服务;数据库出现时它激活,数据库被卸载后它自动停用,而不是继续访问一个已经不存在的东西。运行时通过 notify 和 refresh 持续检查依赖关系,把组件置于激活、停用或不相关三种状态。这就是 reactive coeffects(响应式协同依赖)。
论文还给出一个有意思的性质:合流性(confluence)。只要可组合条件成立、系统最终稳定,无论你是直接加载 A、B、C,还是先装 A、再装 D、卸掉 D、替换一次 B,最后得到的系统状态应该等价。这意味着“怎么走到终态”不会永久污染终态——这对一个会不断试错、反复修改自己的系统非常关键。
把这些机制串起来,DSH 的深层目的就清楚了:让 Agent 不只调用 Harness 提供的能力,还能检查、挂载甚至替换自己的运行时,并且每一次改动都可以撤回、依赖关系可以重建。官方把这称为 Self-Evolving Agent Harness。
三、四种模式,其实是四套实验方法
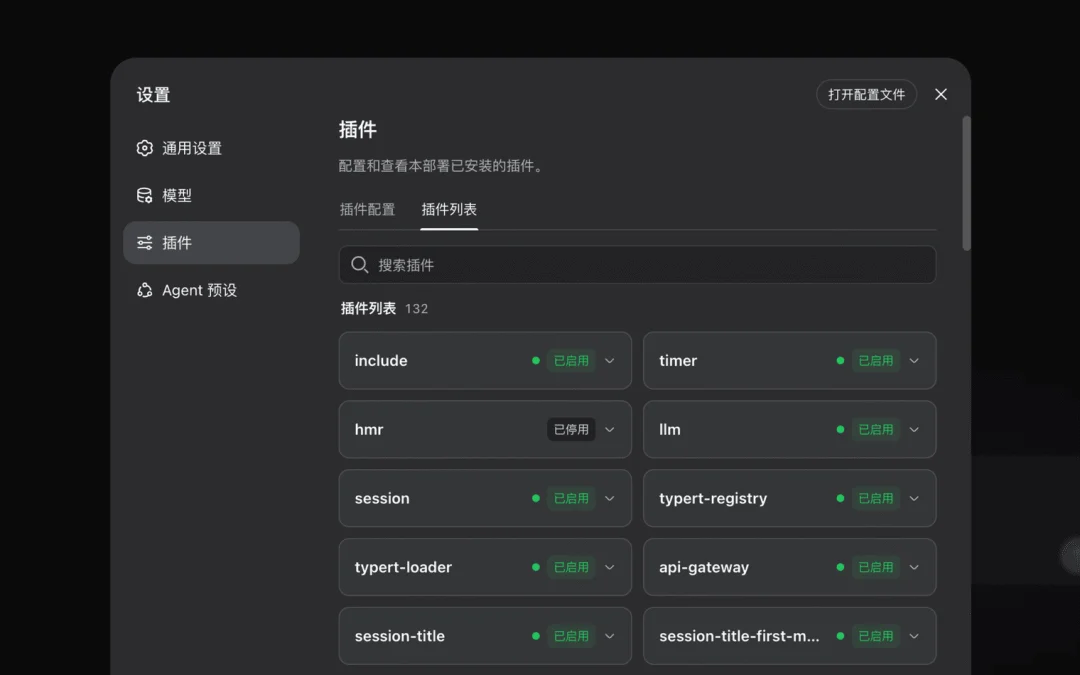
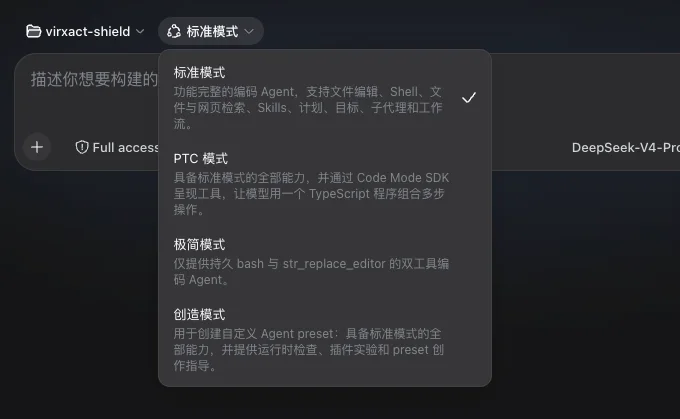
很多人第一次打开 DSH,会被四种模式劝退。其实它们不是四个产品,而是四套不同的插件组合,分别对应不同的使用目的。
标准模式(Standard)是全功能组合,文件编辑、终端、搜索、技能、计划、子 Agent 和工作流都预先配好,日常任务无脑选它。极简模式(Minimal)只保留常驻 Shell 和文件编辑器,系统提示词也极简,主要用于基准测试——尽量把外围工具的差异拿掉,让结果更接近对模型自主能力的观察。
PTC 模式在标准能力之上引入程序化工具调用(Programmatic Tool Calling):模型先写一段 TypeScript 代码,由这段代码把多次读取、搜索、筛选、并行调用和结果整理合并成一次执行。普通工具调用像一道一道点菜,PTC 像给厨师一份菜谱,一口气做完整个流程,适合批量、可并行的多步任务,但对沙箱、超时和资源配额的要求更高。
创造模式(Creator)最特别。它能检查正在运行的 Cordis 环境、在内存里试验插件、再组合出新的运行模式。用社区里流传的一个比喻:Agent 发现自己没有扳手,于是现场造了一把扳手,插到自己手上,接着用这把扳手干活。
| 模式 | 主要插件组合 | 典型用途 |
|---|---|---|
| 标准 Standard | 文件、终端、搜索、技能、计划、目标、子 Agent、工作流 | 日常任务,第一次使用选它 |
| PTC(代码模式) | 标准组合 + Code Mode SDK,模型写 TypeScript 编排多步工具调用 | 批量、可并行、需要多轮串联的任务 |
| 极简 Minimal | 只有常驻 Bash 与文件编辑器,提示词极简 | 模型基准测试,尽量只观察模型本身 |
| 创造 Creator | 标准组合 + 运行时检查、内存中试验插件、组装新模式 | 开发插件、定制新的 Agent 预设 |
四、只增不改的轨迹日志:把一次运行变成可回放的事件流
长任务 Agent 最让人头疼的不是失败,而是不知道它在第几步开始跑偏。DSH 把一次会话设计成一份仅追加(append-only)的事件日志:系统提示词、思考过程、工具调用及结果、子 Agent 调度、上下文注入、压缩和权限变化,都按顺序写进同一份日志。模型每一轮看到的历史,是从这份日志重新推导出来的,不再单独保存另一份“会话状态”。
这让轨迹视图(Trajectory View)可以做四件事:从某一步恢复、从某一步分叉、在历史里搜索、把整段过程重放。当 Agent 在几十步之后做错决定,你可以回到它当时真正看到的上下文,确认问题出在模型判断、工具返回、提示词变化,还是某次上下文注入。
可观测性已经从调试工具变成 Agent 基础设施的标配,OpenAI Agents SDK 和 LangGraph 同样把追踪、持久化与恢复当作核心能力。但仅追加日志也带来新的数据治理问题:完整事件流可能包含代码、内部文件内容和工具返回,可回放提高了可审计性,也扩大了需要保护的数据面。
五、上手第一周的真实体感:模型随便换,插件热加载
DSH 的模型适配器本身就是一个插件。它内置 DeepSeek 直连,也可以通过通用适配器接入其他提供方;所有提供方最终注册到同一个模型服务上,对上层工具和 Agent 循环来说“用谁都一样”。这带来一个有点魔幻但真实的组合:DeepSeek 出的框架,跑着别家的模型,去调第三方的 API。
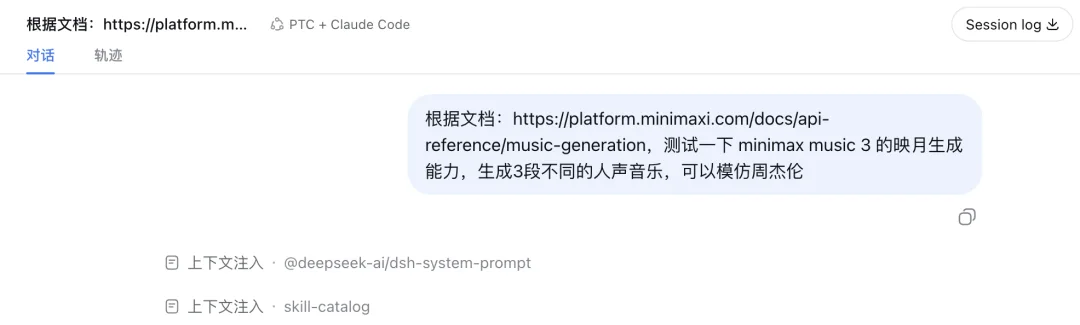
有开发者用 DSH 做过一个实验:接入 Kimi 的模型,让它根据文档测试 MiniMax Music 3 的音乐生成能力。DSH 自己把需求拆成多个任务,约 4 分钟跑完三首歌;统计显示这次运行共 31 步、输入约 77 万 token,缓存命中率达到 95%。这意味着多轮工具调用里,大部分 token 走的是缓存价格,实际成本比逐轮手动问答低得多。
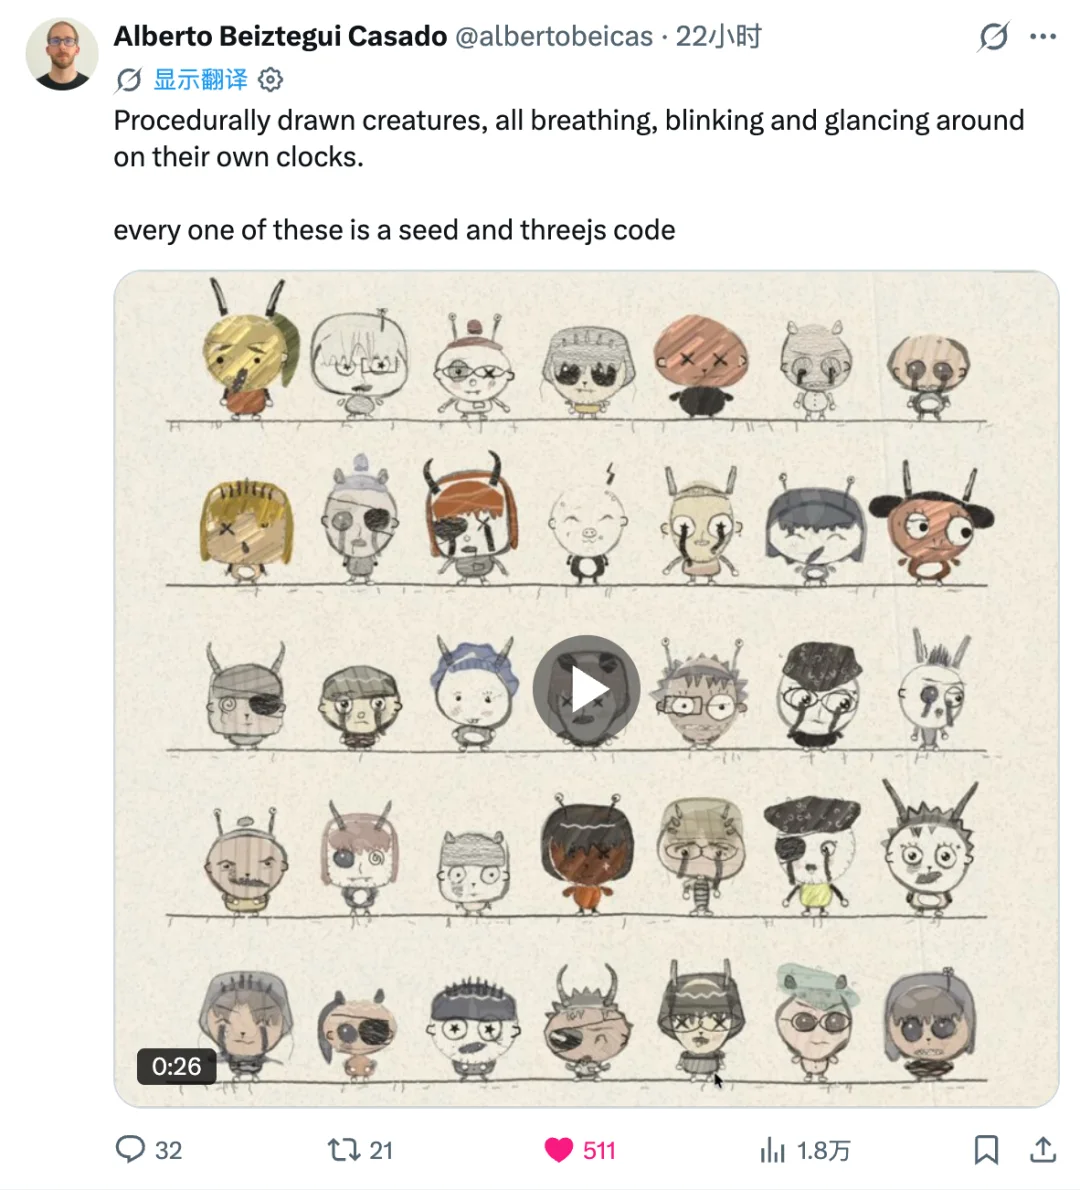
另一个社区玩法是复刻 X 上流行的 Three.js 涂鸦生物:每个角色由 seed 决定长相,带呼吸、眨眼和环顾四周的动画。开发者只用几轮对话就让 DSH 写出了生成代码,还装了名为 sidebar 的社区插件,把 HTML/JS 的实时预览塞进右侧面板,不用再手动开浏览器。
更“套娃”的用法是让 DSH 给 DSH 写插件。DeepSeek 的模型是纯文本模型,默认不能读图,有人让 DSH 自己读插件机制、规划集成方案、写出一个调用第三方识图接口的视觉插件,本地链接后热加载生效。此外,dsh-at-file 补上 @ 引用工作区文件,dsh-cc-tui 把 Claude Code 风格的终端体验搬了进来。缺什么装什么,这是“一切皆插件”在用户层面最直观的感受。
不过要诚实地说:这些体验属于愿意折腾的开发者。DSH 当前的产品化程度并不高,术语密集、默认功能偏少,普通用户打开很容易一头雾水。它更像一个科研和工程实验平台,而不是一个开箱即用的成品。
六、它和 MCP 不是一回事
“一切皆插件”很容易让人联想到 MCP,但两者处在不同层级。MCP 解决的是连接:用统一标准把外部数据、工具和工作流接进 AI 应用;Harness 解决的是运行:什么时候把工具交给模型、调用前要不要审批、结果如何写入会话、失败后是否重试、何时派出子任务、又在什么条件下停止。
在 DSH 里,MCP 服务器可以成为工具来源,Skill 可以成为能力包,而 Cordis 插件负责把模型、工具、状态、循环、界面和政策组合成一个可运行的 Agent。可以把 MCP 理解为插头标准,把 Harness 理解为决定谁在什么时候用电、电用在哪里、出了问题怎么断开的控制层。两者不是竞争关系,更像是相邻的两层。
七、第一重争议:框架免费,但真正烧钱的是 API
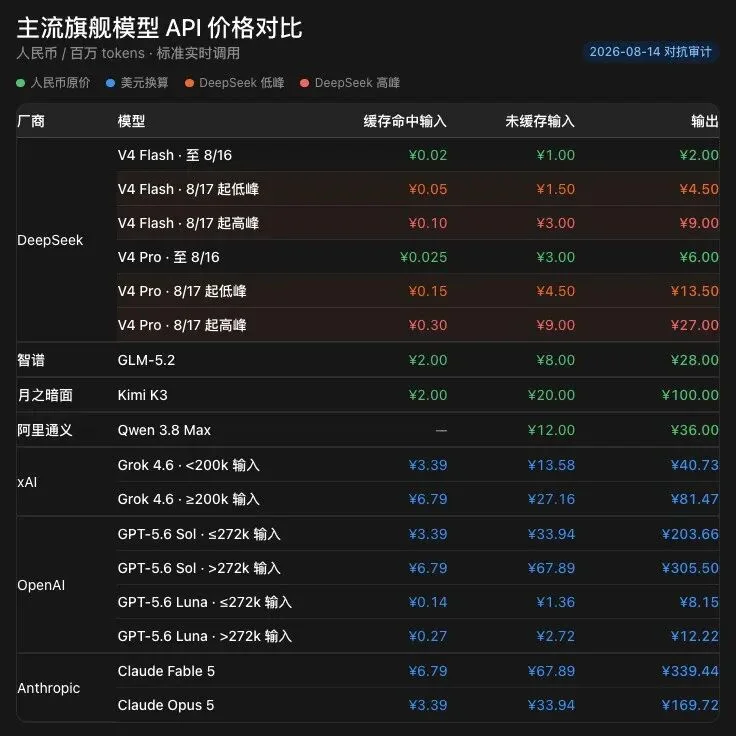
DSH 本身按 MIT 协议免费开源,但要真正跑 Agent,仍然要接模型 API。发布后第四天,也就是 2026 年 8 月 17 日零点,DeepSeek 的峰谷定价正式生效,把成本和框架的关系重新摆到台面上。
按官方公告,高峰时段(北京时间 9:00–12:00、14:00–18:00)V4 Pro 的缓存未命中输入为 9 元/百万 token,输出为 27 元/百万 token,缓存命中输入为 0.3 元/百万 token;空闲时段价格是高峰的一半。V4 Flash 同样上调,高峰输入与输出分别涨至原来的 3 倍和 4.5 倍。对比此前“价格屠夫”的印象,这次调整幅度相当大。
这件事对 Harness 特别敏感。Agent 不是一次问答,而是不断携带上下文、反复调用工具的长任务;单价上涨后,几十轮调用的长任务成本会被逐轮放大。反过来,缓存机制也变得更重要:上下文复用得越好,命中缓存的比例越高,实际支出越接近缓存价。社区那个 95% 缓存命中率的例子,恰好说明“会不会用缓存”正在成为 Harness 工程的一部分。
涨价背后的商业逻辑并不难理解。此前开源平台 OpenCode 披露,V4 Flash 在其平台上单日处理量达到 8 万亿 token,其中约 5 万亿来自免费额度;多家财经媒体把这次调价解读为从价格战回归可持续定价的信号。对个人开发者来说,结论很简单:框架免费不等于 Agent 免费,长任务的 token 账要算在 Harness 设计里。
八、第二重争议:同一个模型,换个 Harness 为什么差 33 分
比涨价更值得较真的是评测。DeepSeek 官方给出的 V4-Pro-0813 成绩单里,Terminal-Bench 2.1 是 87.9 分,但官方表格注明这些代码 Agent 任务全部跑在 DeepSeek Harness 的极简模式下,属于“provider run”。同一个模型换到别的运行环境,数字就开始漂移。
OrcaRouter 收录的一份独立运行得到 78.7 分,与官方相差约 9 分;CoderSera 在中性 harness 下复测只得到 54.68 分,与官方相差 33 分,而且同条件下更小的 V4 Flash 反而拿到 67.04 分。另有多家评测给出的独立指数也明显低于官方 headline。反向的例子同样存在:社交网络上流传的 SWE-bench Verified 96.4% 并非官方口径,官方技术报告扩展编码集里写的是 80.6%,而 96.4% 来自 Vals AI、CoderSera 等第三方的榜单测量。同一个指标,在不同 harness 和测量口径下可以两头漂移。
2026 年 8 月 Composio 做过一个更直观的实验:把同一个 V4-Flash 接进 8 种不同 Harness,各跑 30 个真实多步任务,结果最好的跑通 20 个,最差的只有 14 个;240 次运行里只有 129 次成功。用 Claude Code、Codex、DeepAgents 三种 Harness 完成同一批任务时,单任务成本分别约为 0.195、0.081、0.045 美元,最大相差四倍以上。
| 指标 | DeepSeek 官方口径 | 独立测量口径 | 值得注意的地方 |
|---|---|---|---|
| Terminal-Bench 2.1 | 87.9(官方 Harness 极简模式,标注 provider run) | 78.7(OrcaRouter 收录的独立运行);54.68(CoderSera 中性 harness) | 同一个模型在不同 harness 下最大相差 33 分,Flash 反超 Pro |
| SWE-bench Verified | 80.6(官方技术报告扩展编码集) | 96.40(Vals AI / CoderSera 等第三方测量) | 连“更高分”也可能来自不同 harness 与测量口径,不能互换比较 |
这组数字揭示了一件容易被忽略的事:Harness 不只是“能不能用”的问题,还决定一个模型“看起来多强”。只看一个 headline 分数,而不问它跑在哪个 harness、哪个模式、什么测量口径里,就很容易被数字本身误导。对个人开发者,这意味着读榜单时要多看一眼脚注;对研究者和评测者,这意味着模型能力和工程增益正在越来越难拆开。
九、藏得更深的底牌:自进化 Harness 需要一个“可归因”的环境
如果把视角再拉远一点,DSH 发布前后正是“递归 Harness 自改进”(Recursive Harness Improvement,RHI)研究密集出现的一段时间:Meta-Harness 把 Harness 代码交给编码 Agent 自己改,AHE 把可编辑组件逐个文件化,HarnessCompass 用“泛化门”约束修改不能针对单题打补丁,Harness-R1 甚至单独训练了一个 9B 的 Harness Engineer 模型。7 月 Sakana AI 的《Recursive Harness Self-Improvement》在量化金融、机器人、药物研发三个方向的 30 个机器学习研究任务上,只用几轮 Harness 更新,就让低推理预算的 Agent 反超高推理预算,同时把推理成本最多降低约 60%。
但这一领域仍有三道没解开的难题:到底改什么(Prompt、工具、记忆、中间件、拓扑性质完全不同,却混在同一个搜索空间里);到底怎么改(很多涨点在训练任务上吸收特异性反馈,换到留出任务就消失);什么才算真正递归(如果负责提方案的优化器一直是固定模型,那进化的只是 Harness,不是“改进 Harness 的能力”)。
MIT CSAIL 的一篇工作《Language model harnesses are compositional generalizers》给出了一个值得沿用的视角:Harness 的价值不在“记住所有任务”,而在把第一次见到的完整任务,拆成模型本来就熟悉的局部子任务,再重新组合。好的 Harness 让每次真正送进模型的调用,仍然落在模型熟悉的分布里。
沿着这个视角看,DSH 的插件化就不是为了好看。它把 Harness 切成有稳定语义、可以独立干预、可以撤销、影响范围可以追踪的离散单元,并把“耦合”本身变成运行时可见的依赖图。对强化学习来说,这意味着一轮昂贵执行留下的不再只是一个最终奖励,而是“当前结构—这次干预—影响范围—轨迹变化—最终结果”这样一条更完整的训练信号。终局奖励在长程 Agent 上会越来越稀疏、方差越来越大,一个能让干预边界和奖励归因变得更干净的环境,才是自进化真正需要的底座。
这或许才是 DSH 把一切拆成插件的底层原因:不是为了让人类开发者多几个可选配置,而是为了让未来的优化器有一个可实验、可归因、可撤销的自我修改空间。这个愿景很大,但距离“稳定自进化”还有很长的工程距离——论文是预印本,产品是开发者预览,两者都还在快速变动。
十、开放的另一面:插件供应链与安全风险
开放性越强,治理成本越高。一个工具插件可以接触文件和外部服务,一个存储插件掌握完整会话,一个循环插件则可能直接改变 Agent 的决策路径。插件来源验证、权限边界、依赖冲突、版本兼容和供应链安全,都会成为这套生态能否进入生产环境的前提。
架构本身也有成本。论文承认,为了保持组件独立而额外引入的集成组件,在最坏情况下可能呈 O(n²) 增长;组件越细,交互关系越多,理解与维护成本也会上升。“把一切都插件化”并不自动等于“系统更简单”。
更重要的是版本现实:官方明确警告当前处于 Developer Preview,后续会有不兼容变更;GitHub Releases 页面在发布初期还是空的,版本号停留在 0.1 系列候选。今天能用的配置,明天可能就要改。
结语:现在值得学,不适合现在盲上生产
把上面的内容收拢成一句实用判断:如果对 Agent 的底层机制、多 Agent 协同或 Harness 自进化感兴趣,DSH 是目前少见的把基础设施拆到这么细的开源方案,值得上手和读源码;如果只是想稳定地写完今天的代码,Claude Code、Codex 这些成熟产品仍然更顺手。
黑鲸与蓝鲸的分工,已经把 DeepSeek 的意图写得很明白:蓝鲸负责思考,黑鲸负责让思考在真实世界落地。当模型层的差距被快速抹平,竞争会自然上移到“模型如何被使用”这一层——上下文怎么管理、工具怎么编排、失败怎么恢复、数据从哪里回流。谁掌握运行层,谁就更接近真实任务入口。
从公开招聘 Harness 团队,到把一个真实可下载的 MIT 项目推到开源社区中央,DeepSeek 的判断已经很明确:模型是大脑,Harness 是身体。这套架构不一定能赢,生态、供应链安全和版本稳定都还是未知数;但“运行层会越来越决定 Agent 的上限”这个命题已经被它摆上了台面。对个人开发者来说,现在最值得带走的不是任何一条 headline 分数,而是学会多问一句:这个结果,究竟来自模型本身,还是来自它身下的 Harness?